Techniczny audyt SEO i GEO krok po kroku – checklista
Techniczny audyt SEO i GEO to pełne sprawdzenie witryny pod kątem jej dostępności, czytelności i wiarygodności – zarówno dla klasycznych robotów wyszukiwarek, jak i modeli generatywnych (LLM). Aby przeprowadzić go poprawnie, warto traktować serwis jako ciągły przepływ danych: od wysłania żądania HTTP i pobrania zasobów, przez wykonanie JavaScriptu, aż po odczyt faktów przez systemy odpowiedzi AI.
Współczesne wyniki wyszukiwania i odpowiedzi generowane przez AI coraz bardziej się łączą. Dzisiejsze skuteczne pozycjonowanie stron nie polega już tylko na walce o pierwsze miejsce na liście niebieskich linków. Liczy się także obecność w Google AI Overviews, Perplexity, ChatGPT czy Claude. Te systemy nie patrzą wyłącznie na liczbę słów kluczowych. Sprawdzają dokładność twierdzeń, zgodność informacji o encjach oraz jakość techniczną kodu źródłowego.
Ten przewodnik i dołączona checklista prowadzą przez wszystkie etapy sprawdzania serwisu. Pomogą usunąć błędy, które blokują indeksowanie, uporządkować architekturę informacji i przygotować stronę do wymagań Generative Engine Optimization (GEO).
Czym jest techniczny audyt SEO i GEO?
Klasyczny audyt techniczny SEO skupia się na tym, jak strona współpracuje z robotami wyszukiwarek. Sprawdza, czy crawler może znaleźć podstronę, pobrać jej kod, odczytać go i dodać stronę do indeksu. Jeśli podstawy techniczne nie działają – serwer odpowiada zbyt wolno, skrypty utrudniają odczyt, a linki wewnętrzne prowadzą do błędów – nawet dobra treść może pozostać niewidoczna dla odbiorców.
Audyt GEO, nazywany też audytem SEO AI lub AEO (Answer Engine Optimization), dodaje do tej analizy systemy odpowiedzi. Modele językowe nie tylko zapisują informacje o dokumentach. Tworzą z nich bezpośrednie odpowiedzi. Audyt GEO sprawdza więc, czy treść strony pozwala łatwo wybrać z niej fakty, czy marka jest rozpoznawana jako encja w bazach wiedzy oraz czy boty AI mogą bez problemu przytoczyć konkretne dane z Twojej domeny.
Co sprawdza audyt SEO, a co audyt GEO?
W tradycyjnym SEO analityk bada między innymi statusy odpowiedzi serwera (200, 301, 404), zasady w pliku robots.txt, tagi kanoniczne, wyniki Core Web Vitals oraz działanie strony na urządzeniach mobilnych. Chodzi o to, aby Googlebot mógł bez przeszkód dodać stronę do indeksu i ocenić ją na podstawie wielu sygnałów rankingowych.
Audyt GEO stawia inne pytanie: czy system AI może wybrać z danego adresu URL jasną, samodzielną i wiarygodną informację? Analizuje odpowiedzi serwera na żądania konkretnych botów, takich jak GPTBot, ClaudeBot czy PerplexityBot. Sprawdza też, czy definicje i dane są dostępne w początkowym kodzie HTML, bez wykonywania rozbudowanych skryptów, oraz czy na stronie znajdują się tabele, liczby, procedury i pewne fakty, które algorytm może przytoczyć jako źródło.
Jak ustalić cele, KPI i zakres analizy?
Rozpoczęcie audytu bez wyznaczenia zakresu zwykle kończy się długim raportem, który niewiele mówi o dalszych działaniach. Przed uruchomieniem crawlerów ustal, jaki jest główny cel analizy. Może nim być przygotowanie do migracji, usunięcie przyczyn nagłego spadku ruchu organicznego albo zwiększenie szans na pojawienie się w odpowiedziach asystentów AI.
Wskaźniki efektywności (KPI) warto podzielić na dwa obszary:
- KPI SEO: udział zaindeksowanych podstron w stosunku do adresów zgłoszonych w sitemapie, średni czas odpowiedzi serwera (TTFB), wyniki Core Web Vitals w zielonym zakresie oraz pozycje i ruch organiczny dla fraz informacyjnych i transakcyjnych.
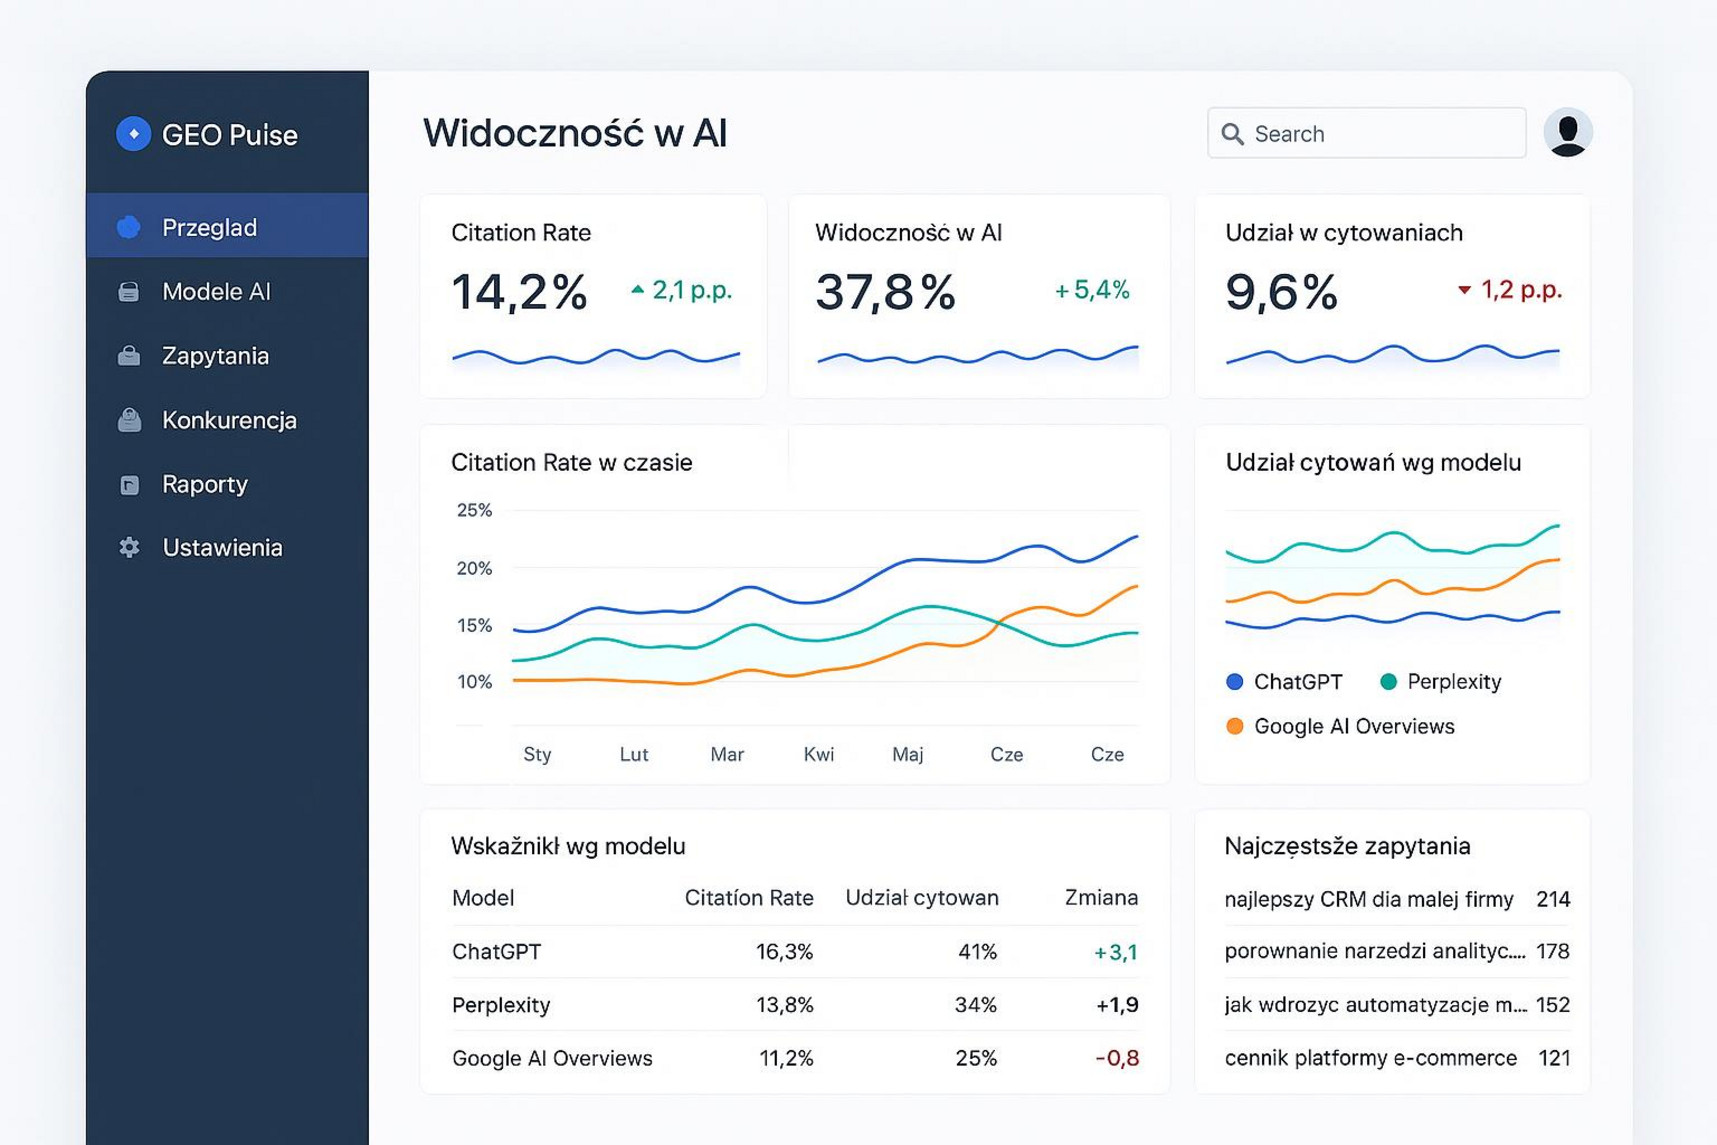
- KPI GEO: wskaźnik cytowalności (Citation Rate – udział odpowiedzi AI, w których pojawia się domena, w grupie badanych zapytań), wskaźnik poprawności cytowań (Correct Citation Rate) oraz Citation Share, czyli udział cytowań marki w porównaniu z konkurencją w danym temacie.
Przygotowanie do audytu: dane, dostęp i narzędzia
Dokładne sprawdzenie wymaga dostępu do środowiska, w którym działa strona. Korzystanie wyłącznie z zewnętrznych skanerów daje tylko część obrazu. Pokazuje, jak serwis wygląda z zewnątrz, ale nie mówi dokładnie, co widzą wyszukiwarki i użytkownicy w swoich warunkach.
Na tym etapie zbierz także dane z wcześniejszych okresów. Jeśli strona była migrowana, padła ofiarą ataku albo zmieniła platformę e-commerce, informacje o tych zdarzeniach pomogą połączyć problemy z indeksowaniem z konkretnymi zmianami technicznymi.
Jakie dostępy są potrzebne do Google Search Console, GA4 i CMS?
Podstawą jest pełny dostęp do Google Search Console, najlepiej jako właściciel usługi domenowej. W GSC znajdziesz dane o błędach indeksowania, wykluczeniach związanych z tagami noindex, danych strukturalnych oraz rzeczywistych wynikach Core Web Vitals z raportu CrUX (Chrome User Experience Report).
Potrzebny jest też dostęp do Google Analytics 4, aby sprawdzić strony przynoszące konwersje i adresy URL bez ruchu. Przydatny będzie dostęp do logów serwera, który pozwala zbadać częstotliwość wizyt Googlebota i crawlerów AI, oraz dostęp administracyjny do CMS. Panel CMS pokaże, jak system tworzy metadane, jak ustawia adresy kanoniczne i czy nie dodaje zbędnych skryptów w sekcji <head>.
Narzędzia do audytu technicznego SEO i GEO: darmowe oraz płatne
Dobierz narzędzia tak, aby łączyły testy laboratoryjne ze sprawdzaniem zachowania robotów na dużej liczbie stron:
- Crawling i architektura: Screaming Frog SEO Spider, który pozwala połączyć dane z GSC i GA4 oraz wykonać renderowanie JavaScriptu, Sitebulb albo narzędzia działające w chmurze, takie jak OnCrawl i Botify, przy serwisach mających ponad 100 000 adresów URL.
- Wydajność i kod: Google PageSpeed Insights, Chrome DevTools, zwłaszcza zakładki Performance i Network, WebPageTest oraz walidator Schema.org / Rich Results Test.
- Widoczność i linki: Ahrefs, Semrush lub Senuto do oceny linków przychodzących, kanibalizacji słów kluczowych i braków w treści.
- Narzędzia GEO: panele do śledzenia widoczności w LLM, analiza logów serwera pod kątem user-agentów, takich jak GPTBot, ClaudeBot i PerplexityBot, oraz stałe arkusze do testów promptów zakupowych i porównawczych w Gemini, Perplexity, Copilot i ChatGPT.
Crawlability i indeksacja: czy roboty mogą znaleźć stronę?
Etap crawlability i indeksacji odpowiada na podstawowe pytanie: czy algorytmy mogą dotrzeć do treści serwisu i zapisać ją w swoich bazach? Nawet mały błąd w plikach konfiguracyjnych może wykluczyć z wyszukiwarki ważne części sklepu lub serwisu informacyjnego.
Obecność strony w wynikach obejmuje trzy etapy: pobieranie (crawling), renderowanie, czyli wykonanie CSS i JavaScriptu, oraz indeksowanie, czyli zapis przetworzonego dokumentu w bazie. Boty AI często pomijają renderowanie, aby ograniczyć zużycie mocy obliczeniowej. Z tego powodu bardzo ważne jest, aby tekst był dostępny już w pierwszym pakiecie danych.
Jak sprawdzić plik robots.txt i dyrektywy dla robotów?
Plik robots.txt jest jednym z pierwszych dokumentów sprawdzanych przez roboty sieciowe. Sprawdź, czy nie ma w nim błędnych reguł Disallow: /, które blokują cały serwis lub ważne foldery z plikami CSS, grafikami i bibliotekami JS potrzebnymi do wyświetlenia strony.
Blokada adresu w robots.txt nie usuwa go z indeksu Google. Jeśli do strony prowadzą linki z innych witryn, robot może zapisać sam adres URL bez dostępu do jego treści. Sprawdź też zasady dotyczące poszczególnych botów AI:
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Allow: /
User-agent: GPTBot
Allow: /
User-agent: PerplexityBot
Allow: /
Jeśli chcesz pojawiać się w systemach generatywnych, sprawdź, czy zapora WAF lub plik robots.txt nie odrzuca żądań od oficjalnych crawlerów AI, uznając je błędnie za nieautoryzowane scrapery.
Czy mapa sitemap.xml zawiera właściwe i indeksowalne adresy?
Mapa XML powinna zawierać najważniejsze, kanoniczne strony serwisu. Częsty błąd polega na dodawaniu do sitemapy wszystkich adresów utworzonych przez CMS, w tym przekierowań 301, stron 404, adresów z filtrami oraz podstron z tagiem noindex.
Podczas audytu sprawdź, czy plik sitemap.xml:
- zawiera tylko adresy zwracające kod HTTP 200,
- jest podzielony na mniejsze pliki, maksymalnie po 50 000 adresów lub 50 MB każdy, połączone nadrzędnym indeksem sitemap,
- jest regularnie aktualizowany i ma prawdziwy znacznik <lastmod>, który pokazuje rzeczywistą zmianę treści, a nie tylko automatyczną zmianę daty przez skrypt crona,
- został zgłoszony w Google Search Console i Bing Webmaster Tools.
Statusy HTTP, przekierowania i dostępność serwera
Przeglądarka i serwer porozumiewają się za pomocą kodów statusu HTTP. Problemy w tej wymianie marnują budżet indeksowania (crawl budget) i zniechęcają osoby, które trafiają na niedziałające adresy.
W audycie nie wystarczy sprawdzić strony głównej. Przeanalizuj kody odpowiedzi dla całej domeny. Zwróć uwagę na ukryte pętle przekierowań oraz podstrony, które dla nieistniejących zasobów zwracają błędnie kod 200. Są to tak zwane soft 404.
Jak znaleźć błędy 4xx, 5xx i nieprawidłowe strony błędu?
Uruchom crawl serwisu w Screaming Frog i przefiltruj wyniki według kodów odpowiedzi. Błędy 4xx oznaczają, że link wewnętrzny lub zewnętrzny prowadzi do usuniętego albo przeniesionego zasobu, dla którego nie ustawiono właściwego przekierowania. Każdy wewnętrzny link do błędu 404 oznacza utratę części mocy linkowania oraz informuje algorytm, że strona jest słabo utrzymywana.
Błędy 5xx są szczególnie poważne. Pokazują, że serwer nie przetworzył żądania z powodu przeciążenia bazy danych, błędu w kodzie PHP lub Python albo przekroczenia czasu odpowiedzi bramy sieciowej. Jeśli roboty często widzą kod 500 lub 503, ograniczają liczbę wizyt na domenie. Może to doprowadzić do usunięcia ważnych podstron z indeksu.
Sprawdź również, czy nieistniejące podstrony zwracają jasny nagłówek 404 Not Found lub 410 Gone. Strona błędu 404 powinna mieć prostą nawigację, która prowadzi użytkownika do działających części serwisu.
Architektura serwisu, adresy URL i linkowanie wewnętrzne
Logiczna budowa witryny jest podstawą optymalizacji technicznej. Pozwala robotom łatwo przechodzić między tematami, a użytkownikom znaleźć właściwą drogę do zakupu lub informacji.
W GEO struktura strony ma jeszcze jedno zadanie. Pomaga modelom AI odczytać hierarchię pojęć i związki między encjami, na przykład: marka > kategoria usług > konkretne rozwiązanie > specyfikacja techniczna.
Czy struktura kategorii i głębokość kliknięć wspierają indeksację?
Głębokość kliknięć (crawl depth) mówi, ile kliknięć dzieli stronę główną od danego adresu URL. Dobra zasada SEO zakłada, że ważne podstrony ofertowe, kategorie i kluczowe artykuły blogowe powinny być dostępne w maksymalnie trzech kliknięciach od strony głównej (Depth ≤ 3).
Wprowadź linkowanie zgodne z hierarchią oraz menu okruszkowe (breadcrumbs). Twórz klastry tematyczne (topic clusters), w których szczegółowe artykuły prowadzą do nadrzędnej strony filarowej (pillar page). W ten sposób wzmacniają jej znaczenie w danym temacie. Unikaj stron osieroconych (orphan pages), czyli dokumentów obecnych na serwerze, do których nie prowadzi żaden link w kodzie HTML.
Jak sprawdzić tagi canonical i alternatywne wersje strony?
Adres kanoniczny (rel=”canonical”) wskazuje wyszukiwarce, która wersja strony jest oryginalna, gdy podobna treść występuje pod kilkoma adresami URL. Taka sytuacja może pojawić się przy stronicowaniu, sortowaniu produktów lub parametrach śledzących UTM.
Podczas audytu sprawdź:
- czy każda unikalna podstrona ma samoreferujący tag kanoniczny, czyli wskazujący na własny adres,
- czy adresy kanoniczne są ustawione w jednolity sposób; tag w sekcji <head> powinien wskazywać pełny adres URL z protokołem HTTPS oraz właściwą wersję www lub bez www,
- czy na stronie wielojęzycznej poprawnie ustawiono tagi hreflang, które wzajemnie wskazują wersje językowe i regionalne.
Wydajność, mobile i bezpieczeństwo techniczne
Dzisiejszy internet jest w dużej mierze używany na telefonach. Zgodnie z zasadą Mobile-First Indexing Google ocenia i indeksuje strony na podstawie ich wersji mobilnej. Jeśli witryna działa dobrze na komputerze, ale na telefonie gubi elementy menu albo zacina się przy przewijaniu, jej widoczność może wyraźnie spaść.
Szybkość ma znaczenie także dla robotów. Serwer, który szybko odpowiada, pozwala sprawdzić więcej stron przy mniejszym zużyciu zasobów. Dzięki temu nowe i zmienione materiały mogą szybciej trafić do indeksu.
Jak sprawdzić Core Web Vitals: LCP, INP i CLS?
Core Web Vitals, czyli podstawowe wskaźniki internetowe, są jednym z czynników używanych przez algorytmy Google. W analizie sprawdź trzy wartości:
| Wskaźnik | Co mierzy? | Dobry wynik | Obszar optymalizacji |
| LCP (Largest Contentful Paint) | Czas wyświetlenia największego elementu treści, na przykład banera lub nagłówka H1. | ≤ 2,5 sekundy | Kompresja grafik (WebP/AVIF), poprawa TTFB i wcześniejsze ładowanie ważnych zasobów. |
| INP (Interaction to Next Paint) | Czas reakcji strony na kliknięcie lub dotknięcie ekranu; zastąpił wskaźnik FID. | ≤ 200 milisekund | Ograniczenie długich zadań JavaScript (Long Tasks), podział skryptów i poprawa hydration. |
| CLS (Cumulative Layout Shift) | Stabilność układu, czyli brak nagłego przesuwania się elementów. | ≤ 0,1 | Podanie wymiarów grafik i reklam (width/height) oraz unikanie dynamicznego dodawania elementów DOM. |
Korzystaj z danych w Google Search Console i PageSpeed Insights. Zwróć szczególną uwagę na dane rzeczywiste (Field Data / CrUX), ponieważ pokazują doświadczenia prawdziwych użytkowników korzystających z różnych urządzeń i rodzajów połączenia.
Jak zweryfikować HTTPS, certyfikat SSL i mieszane treści?
Bezpieczeństwo domeny jest podstawą działania strony. Certyfikat SSL powinien być poprawnie zainstalowany, ważny i ustawiony z użyciem nowoczesnych protokołów TLS 1.3. Wszystkie adresy bez szyfrowania (http://) należy przekierować kodem 301 na wersję szyfrowaną (https://).
Sprawdź też mieszane treści (Mixed Content). Pojawiają się wtedy, gdy strona otwierana przez HTTPS pobiera skrypty, style, grafiki lub czcionki przez nieszyfrowany protokół HTTP. Przeglądarki często blokują takie zasoby. Może to zepsuć wygląd strony albo wywołać ostrzeżenie o braku bezpieczeństwa.
HTML, treść i dane strukturalne dla SEO oraz GEO
Semantyczna budowa HTML pomaga algorytmom zrozumieć stronę. Odpowiednie znaczniki pokazują cel publikacji, oddzielają poszczególne części i ułatwiają odczyt głównych tez artykułu albo parametrów produktu.
W GEO czysty kod HTML ma duże znaczenie. Boty AI łatwiej odczytują standardowe znaczniki, takie jak <article>, <header>, <section> i <table>, niż wiele zagnieżdżonych i nieopisanych elementów <div> tworzonych przez rozbudowane edytory wizualne.
Czy tytuły, nagłówki H1-H6 i meta description opisują intencję strony?
Tag <title> jest jednym z ważnych sygnałów on-page. Powinien być unikalny, krótki – zalecana długość to 55-60 znaków ze spacjami – i naturalnie zawierać główną frazę. Opis meta description nie zmienia bezpośrednio pozycji strony, ale może wpływać na CTR w wynikach organicznych. Daje także modelom AI krótki opis podstrony.
Układ nagłówków powinien tworzyć jasny plan dokumentu:
- Jedna strona powinna mieć dokładnie jeden nagłówek <h1>, który określa główny temat.
- Nagłówki <h2> i <h3> powinny wyznaczać sekcje i podtematy. Formułuj je konkretnie. Unikaj niejasnych metafor, które utrudniają algorytmom odczyt tematu.
- Pierwsze zdanie pod każdym nagłówkiem drugiego poziomu powinno od razu odpowiadać na pytanie zawarte w tytule sekcji. Ułatwia to przytoczenie fragmentu w Google AI Overviews.
Jak wdrożyć Schema.org: Organization, Article, Product, FAQ i BreadcrumbList?
Dane strukturalne, najczęściej zapisane jako JSON-LD, przekazują robotom uporządkowane informacje o stronie. Pomagają wyszukiwarkom tworzyć elementy rozszerzone (Rich Results), a modelom LLM łączyć fakty z właściwymi encjami.
Najczęściej używane typy schematów to:
- Organization / LocalBusiness – opisuje markę, logo, dane kontaktowe, NIP, profile społecznościowe przez właściwość sameAs oraz powiązania kapitałowe.
- Article / BlogPosting – wskazuje autora jako encję typu Person, datę publikacji, datę zmiany treści oraz organizację wydającą materiał.
- Product – w sklepie podaje cenę, walutę, dostępność produktu i jego identyfikatory handlowe, takie jak GTIN, MPN i SKU.
- FAQPage – porządkuje pytania i krótkie odpowiedzi, dzięki czemu wiedzę łatwo odczytać maszynowo.
- BreadcrumbList – zapisuje ścieżkę okruszkową i pomaga zrozumieć budowę serwisu.
Wszystkie informacje zapisane w JSON-LD muszą być w pełni zgodne z treścią widoczną dla użytkownika. Ukrywanie innych danych w znacznikach strukturalnych może skończyć się karą ręczną od Google.
E-E-A-T, autorzy i wiarygodność informacji
E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) to zestaw zasad jakości, który pomaga Google i ewaluatorom jakości (Quality Raters) oceniać wiarygodność źródła. Przy dużej liczbie treści tworzonych przez AI doświadczenie i autorytet ludzi stają się ważnym sposobem budowania zaufania do serwisu.
Jak zwracają uwagę eksperci z skuteczne-pozycjonowanie-stron.pl, w audycie technicznym E-E-A-T nie jest tylko ogólną ideą. Widać je w konkretnych elementach kodu i budowie strony, które pokazują, kto stworzył materiał i kto odpowiada za jego publikację.
Czy strona prezentuje doświadczenie, kompetencje i odpowiedzialność autora?
Każdy materiał merytoryczny, szczególnie dotyczący obszarów YMYL (Your Money Your Life – finanse, prawo, medycyna i technologia), powinien mieć podpis konkretnego specjalisty. Podczas audytu sprawdź:
- czy autor ma własną stronę z biogramem, informacjami o wykształceniu, linkami do publikacji zewnętrznych i profilami zawodowymi, na przykład LinkedIn,
- czy kod artykułu łączy właściwość author ze schematem Person oraz właściwością sameAs, która prowadzi do profili autora w internecie,
- czy serwis ma jasne podstrony „O nas”, „Zespół”, „Redakcja”, „Polityka prywatności” i regulaminy z pełnymi danymi firmy, w tym NIP, REGON i KRS,
- czy teksty odwołują się do pierwotnych publikacji naukowych, badań branżowych i oficjalnych aktów prawnych. Takie źródła zwiększają zaufanie do informacji także w modelach językowych.
Audyt GEO: widoczność marki w wyszukiwarkach i odpowiedziach AI
Audyt GEO wymaga patrzenia na stronę nie tylko jak na pojedynczy tekst, ale jak na uporządkowaną bazę wiedzy. Modele takie jak ChatGPT, Gemini i Perplexity nie czytają stron dokładnie tak jak ludzie. Szukają w sieci zestawów faktów, które mogą połączyć z pytaniem użytkownika za pomocą mechanizmów retrieval-augmented generation (RAG).
Jeśli treści składają się głównie z ogólnych haseł marketingowych o „profesjonalnym podejściu” i „najwyższej jakości”, systemy tworzące odpowiedzi mogą je pominąć. Potrzebują konkretnych danych: liczb, parametrów, definicji, ograniczeń i dowodów, które można zmierzyć.
Jak budować cytowalność: definicje, dane, źródła i jednoznaczne odpowiedzi?
Aby strona była chętnie cytowana przez modele generatywne, treść musi być łatwa do szybkiego odczytu. W audycie GEO szukamy samodzielnych fragmentów (self-contained passages), czyli akapitów, które zachowują pełne znaczenie nawet po wyjęciu z całego artykułu.
Dobry fragment do cytowania powinien mieć pięć elementów:
- Jasną definicję: jednoznaczne wyjaśnienie pojęcia w pierwszym zdaniu sekcji.
- Konkretne dane: liczby z jednostką, datą pomiaru i informacją, do jakiej grupy lub całości się odnoszą.
- Zakres zastosowania: wskazanie rynku, grupy odbiorców albo warunków prawnych i technicznych.
- Źródło: bezpośrednie wskazanie metody badania lub pierwotnego raportu.
- Wyjątki: jasne pokazanie sytuacji, w których dana zasada nie działa.
Duże znaczenie mają tabele porównawcze oraz listy procedur opisanych krok po kroku. Dzięki nim modele AI mogą tworzyć podsumowania z mniejszym ryzykiem błędnego uzupełniania informacji.
Jak monitorować obecność marki w Google AI Overviews i narzędziach generatywnych?
Google pokazuje ruch z AI Overviews w Google Search Console zbiorczo, w ramach kategorii „Sieć”. Zwykły raport nie powie więc wprost, czy wyświetlenie pochodziło z boksu AI, czy z klasycznego wyniku. Z tego powodu widoczność GEO trzeba sprawdzać przy użyciu osobnych testów.
Przygotuj stałą listę 30-50 promptów związanych ze ścieżką zakupową klientów. Uwzględnij pytania definicyjne, porównawcze, takie jak „co wybrać: A czy B?”, pytania o problemy techniczne oraz zapytania zawierające nazwę Twojej marki. Powtarzaj testy w narzędziach AI w takich samych warunkach: w czystej sesji i przy tej samej lokalizacji. Sprawdzaj nie tylko, czy marka się pojawiła. Zobacz też, czy asystent podał właściwy URL, czy cytowane dane są aktualne i czy odpowiedź nie zawiera błędów rzeczowych.
Checklista technicznego audytu SEO i GEO krok po kroku
Poniższa checklista to praktyczna lista kontrolna. Użyj jej podczas sprawdzania serwisu i zaznaczaj wykonane punkty.
| Obszar | Zadanie do weryfikacji | Stan / Narzędzie |
| Dostępność i Crawling | Plik robots.txt nie blokuje ważnych części serwisu ani botów AI, takich jak GPTBot, ClaudeBot i Google-Extended. | robots.txt / GSC |
| Dostępność i Crawling | Plik sitemap.xml zawiera tylko kanoniczne adresy ze statusem HTTP 200 i ma aktualne znaczniki <lastmod>. | Screaming Frog / GSC |
| Kody odpowiedzi | Usunięto wewnętrzne błędy 4xx i 5xx oraz łańcuchy i pętle przekierowań 301. | Screaming Frog / Logi serwera |
| Architektura | Głębokość kliknięć dla ważnych podstron wynosi maksymalnie 3 od strony głównej. | Screaming Frog / Sitebulb |
| Kanoniczność | Tagi rel=”canonical” działają poprawnie, nie powodują konfliktów i wskazują pełne adresy URL. | Weryfikacja kodu DOM |
| Wydajność | Wyniki Core Web Vitals mieszczą się w zielonym zakresie: LCP ≤ 2,5 s, INP ≤ 200 ms, CLS ≤ 0,1. | PageSpeed Insights / CrUX |
| Bezpieczeństwo | Certyfikat SSL działa poprawnie, nie ma mieszanych treści, a adresy są przekierowywane na HTTPS. | Chrome DevTools / SSL Labs |
| Struktura HTML | Hierarchia H1-H6 jest poprawna, tagi title są unikalne i mają 55-60 znaków, a meta description pasuje do celu strony. | Crawling SEO |
| Dane strukturalne | Znaczniki Schema.org, takie jak Organization, Article, Product i FAQPage, są poprawne i zapisane w JSON-LD. | Rich Results Test |
| Wiara i E-E-A-T | Autorzy mają profile i biogramy, linki zewnętrzne przez sameAs, a stopka i strona „O nas” zawierają pełne dane firmy. | Weryfikacja manualna |
| Gotowość GEO | Najważniejsze tezy, definicje i tabele są dostępne w surowym HTML, bez konieczności uruchamiania JavaScriptu. | Wyłączenie JS w przeglądarce |
| Ekstrakcja wiedzy | Na stronach ofertowych i blogowych znajdują się konkretne dane, liczby, procedury oraz źródła. | Audyt treści pod LLM |
Jak ustalić priorytety i zamienić raport w plan napraw?
Dużym problemem audytów technicznych jest przekazanie klientowi długiej listy błędów bez podziału na grupy. Programiści i właściciele serwisów nie wiedzą wtedy, od czego zacząć, a prace często zostają wstrzymane.
Zadaniem audytora jest zamiana wniosków na plan działań powiązany z celami firmy. Błędy należy porządkować nie według tego, które najłatwiej naprawić, ale według ich wpływu na widoczność, konwersje i stabilność strony.
Jak ocenić wpływ, koszt, ryzyko i czas wdrożenia?
Do ustalenia kolejności prac możesz użyć matrycy wagowej. Każde zadanie oceniasz według wzoru:
Wartość Wdrożenia = (Wpływ na Indeksację i Ruch × Wartość Biznesowa Adresu) / (Koszt Roboczogodzin × Ryzyko Wdrożeniowe)
Praktyczny plan napraw można podzielić na 30, 60 i 90 dni:
- Dni 0-30 (Najpilniejsze blokady techniczne): usunięcie blokad w robots.txt, poprawa tagów noindex na stronach produktów, usunięcie błędów 5xx i pętli przekierowań, instalacja certyfikatu SSL oraz naprawa problemów, które uniemożliwiają renderowanie.
- Dni 31-60 (Architektura i wydajność): poprawa Core Web Vitals, szczególnie LCP i INP, uporządkowanie linków wewnętrznych, usunięcie konfliktów między adresami kanonicznymi oraz wdrożenie podstawowych schematów Schema.org, takich jak Organization, Product i Article.
- Dni 61-90 (GEO i znaczenie treści): przygotowanie treści do odczytu przez AI, między innymi przez dodanie tabel i definicji, wdrożenie bardziej rozbudowanych danych strukturalnych, uzupełnienie profili autorów zgodnie z E-E-A-T, testy cytowalności w narzędziach generatywnych oraz poprawa klastrów dowodowych.
Monitoring i raportowanie efektów po audycie
Wdrożenie zmian programistycznych nie kończy audytu. Po publikacji poprawek trzeba rozpocząć stałą kontrolę. Od razu uruchom ponowny crawl (re-crawl), aby sprawdzić, czy zmiany nie wywołały nowych problemów w innych częściach serwisu.
Raport powinien łączyć dane o ruchu z informacjami o zachowaniu użytkowników i botów. Tylko wtedy można ocenić, czy wydatki na naprawę problemów technicznych przynoszą firmie zwrot.
Jak monitorować indeksację, błędy, ruch organiczny i konwersje?
Utwórz regularny pulpit, na przykład w Looker Studio, i połącz w nim najważniejsze źródła danych:
- Google Search Console: sprawdzaj raport „Stan indeksowania stron”. Dobrym sygnałem jest spadek liczby adresów w stanach „Wykryto – obecnie nie zindeksowano” oraz „Zindeksowano, ale brak w sitemapie”. Jednocześnie powinna rosnąć liczba poprawnie zaindeksowanych stron ze statusem 200.
- Logi serwera: obserwuj liczbę żądań Googlebota i botów AI. Częstsze wizyty crawlera na poprawionych podstronach mogą być pierwszym sygnałem poprawy widoczności.
- Google Analytics 4: śledź ruch organiczny na stronach objętych zmianami. Analizuj nie tylko liczbę sesji, ale też zaangażowanie i ważne konwersje, takie jak zakupy oraz wysłane formularze kontaktowe.
- Pozycje i intencje w SERP: sprawdzaj średnie pozycje dla fraz brandowych i ogólnych. Monitoruj również, czy wokół poprawionych artykułów rośnie liczba długich, konwersacyjnych zapytań (long-tail), które mogą wiązać się z rekomendacjami tworzonymi przez asystentów AI.
Wyszukiwanie zmierza w stronę autonomicznych agentów AI. Takie systemy mogą w imieniu klientów wyszukiwać informacje, porównywać oferty, a nawet przeprowadzać transakcje bez bezpośredniego udziału człowieka na tradycyjnej stronie. Z tego powodu przejrzysty kod, zgodność z unijnymi zasadami oznaczania treści oraz pełna dostępność cyfrowa interfejsów stają się warunkiem działania witryny w nowoczesnym, maszynowym internecie.
artykuł sponsorowany